티스토리 뷰
배경 Qwen2.5-0.5B를 GPT-4o-mini로 Knowledge Distillation할 때, 학습 라벨에 evidence(근거 문장) 필드를 포함시켰다. 그런데 모델은 evidence를 제대로 출력하지 못했고 — bullets와 매칭되지 않거나 0으로 채우는 경우가 많았다. 프롬프트 제약, few-shot 변경, 후처리 로직 추가 등 다양한 시도를 해봤지만 성능 변화가 없었다.
가설 그렇다면 처음부터 evidence 없는 라벨로 학습시키는 게 낫지 않을까? 티처 모델도 evidence 생성에 capacity를 쓰지 않으면 나머지 태스크 품질이 더 높아질 것이고, 학생 모델도 그걸 더 잘 학습할 것이다.
실험 설계
- A: evidence 포함 라벨로 학습 → 추론/후처리/최종 출력에서 evidence 제거
- B: evidence 제외 라벨로 학습 → evidence 없이 추론
결과
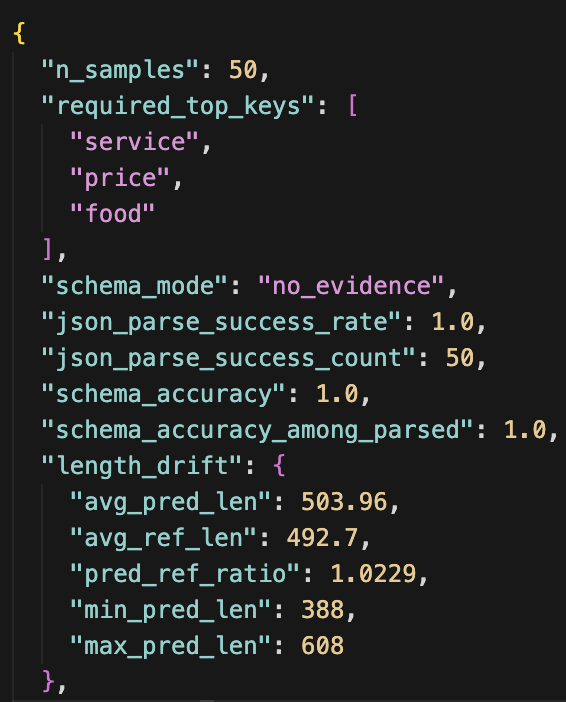
| A (evidence 포함 학습) | 100% | 100% |
| B (evidence 제외 학습) | 52% | 52% |
가설이 틀렸다.
인사이트 모델이 evidence를 제대로 '출력'하지 못하더라도, evidence를 도출하려는 학습 과정 자체가 JSON 구조화 능력을 강화하는 regularization 역할을 한다. 정확한 메커니즘은 불명확하지만, 결과는 명확했다. 이 비교 실험을 수행하지 않았다면 최적 셋팅을 놓쳤을 것이다.
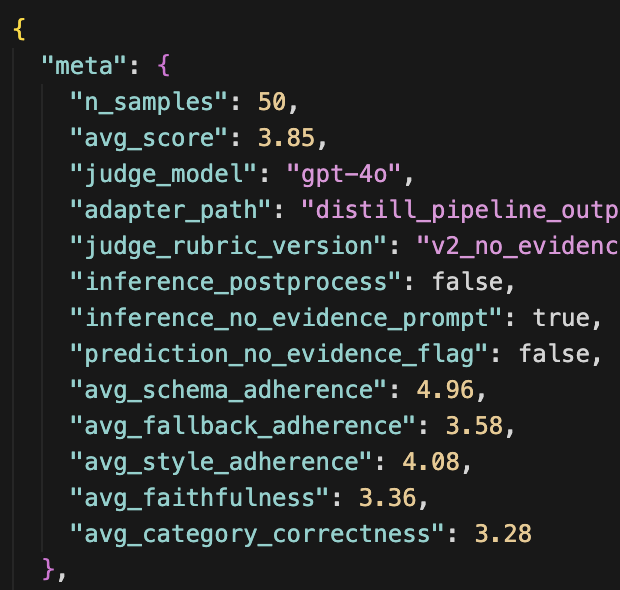
Metrics
1. evidence 라벨 학습, evidence 관련 프롬프트 제거, evidence 관련 후처리 제거, 최종 출력에서 evidence 키 제거 후 평가
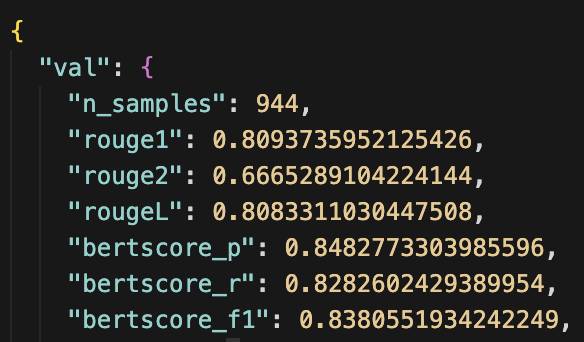
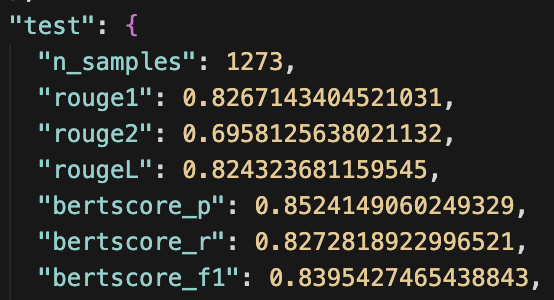
ROUGE,BERTscore
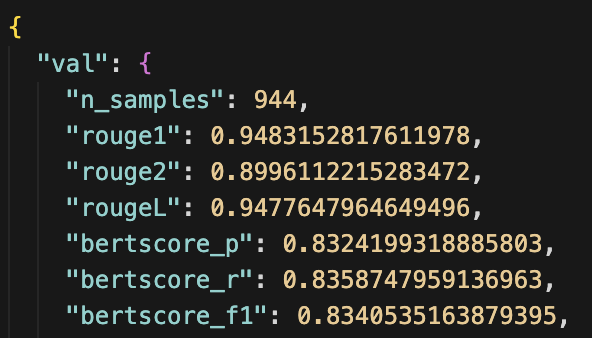
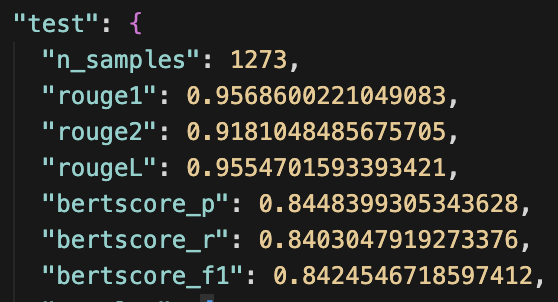
,
LLM as a Judge
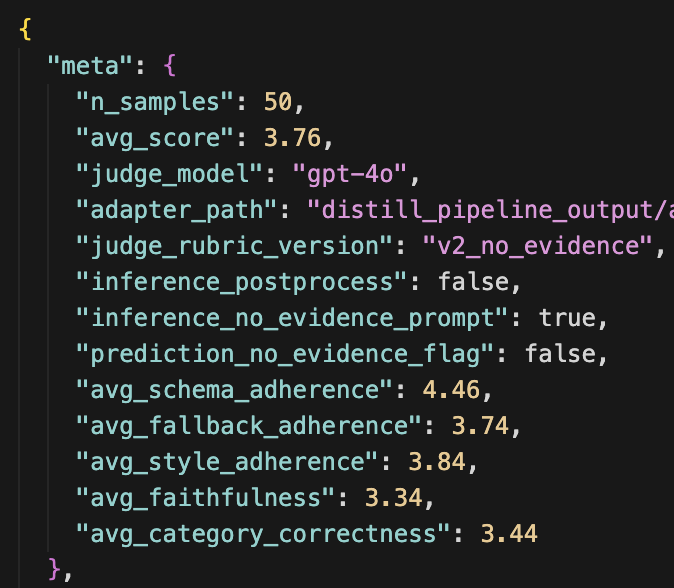
Structure Metrics
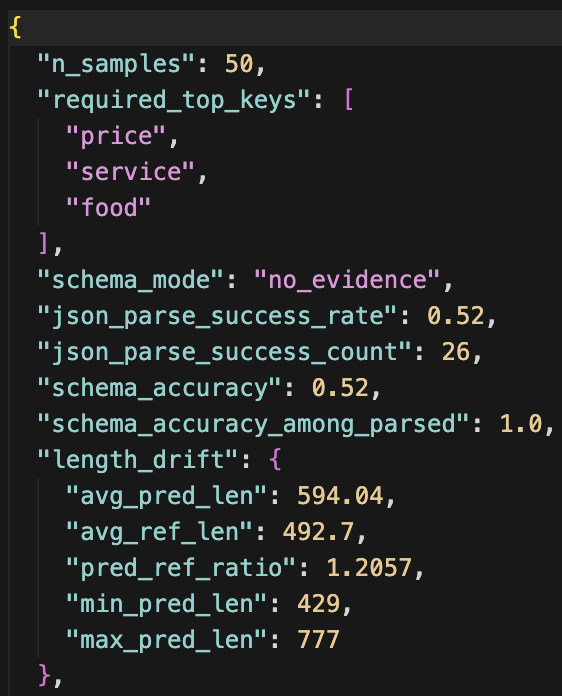
2. evidence 라벨 학습 x, evidence 관련 프롬프트 제거, evidence 관련 후처리 제거, 최종 출력에서 evidence 키 제거 후 평가 x
ROUGE,BERTscore
LLM as a Judge
Structure Metrics